Jetzt mal ganz ehrlich: Das Problem klingt langweilig, und es blockiert mehr Projekte, als man denkt. Eine Software läuft bei einem grossen Betrieb, Behörde, Bank, Versicherung. Sie soll getestet werden, automatisiert, schnell, mit echten Fällen. Und die echten Fälle darf niemand sehen.
Das Problem
Bei grossen Government-Betrieben, und nicht nur dort, darf man Kundendaten nicht einfach im Klartext auf ein Testsystem stellen. Das ist kein Übervorsicht, das ist Gesetz, und es ist richtig so. Also arbeitet das Testteam mit Daten, die es nicht hat. Es baut sich Fälle aus, rät, wie eine Adresse in Produktion aussieht, wie ein Betrag formatiert ist, ob ein Status gross oder klein geschrieben wird.
Und dann geht die Software live, und in der Produktion steht im Feld Status „paid" statt „PAID", im Betrag steht 89.504 statt 89.50, in der IBAN stehen Leerzeichen, und das Datum fehlt in jedem zehnten Datensatz. Nichts davon war im Test. Weil niemand im Test die Produktion kannte.
Synthetisch ist sauber. Zu sauber.
Die übliche Antwort heisst synthetische Daten. Man generiert Kunden, die es nicht gibt, mit Adressen, die es nicht gibt, und testet damit. Das löst das Datenschutzproblem. Es löst nicht das Testproblem.
Fakt ist: Synthetische Daten sind sauber generiert, ohne Fehler. Produktionsdaten haben Fehler. Genau die Fehler, die man mit Testfällen finden müsste, sind in den synthetischen Daten nicht drin, weil sie niemand absichtlich hineinschreibt. Man testet also gegen eine Welt, die ordentlicher ist als die echte, und wundert sich dann in der echten.
Die Idee: Hashes vergleichen, nicht Werte
Im Juli 2025 habe ich ein Notebook aufgemacht und angefangen. Die Idee ist einfach: Man schickt jedes Feld eines Datensatzes durch eine Einwegfunktion, einen Hash. Aus „PAID" wird eine lange Zufallszahl. Aus 89.50 auch. Das macht man mit dem Datensatz aus der Produktion und mit dem entsprechenden Datensatz aus dem Test. Dann vergleicht man nur noch die Zufallszahlen.
Niemand sieht einen Wert. Aber jeder sieht: Das Feld Status ist anders. Das Feld Datum fehlt im Test. Das Feld Betrag weicht ab. Und das reicht für einen Tester, um einen Fall zu bauen, der die Produktion trifft. Automatisiert, pro Datensatz, tausendfach, ohne dass ein Mensch je eine Kundennummer liest.
Ich habe daraus im ersten Anlauf Bilder gemacht. Jedes Feld ein Pixel, die Farbe aus dem Hash. Produktion ein Bild, Test ein Bild, und ein drittes mit der Differenz. Das sah gut aus. Man hat sofort gesehen, wo es klemmt. Und ein Sprachmodell hat aus dem Unterschied einen Satz für das Jira-Ticket gemacht: „Attribut date gelöscht, amount modifiziert, status Gross- und Kleinschreibung geändert."
Der Fehler im ersten Prototyp
Und jetzt der Teil, den ich am wenigsten gern erzähle. Ich habe den Prototyp ein paar Wochen später nochmal angeschaut, mit Abstand. Drei Dinge waren falsch. Eines davon war genau der Fehler, den das Ganze verhindern sollte.
Die Pixeldifferenz sagt nichts. Der Hash von 89.50 und der Hash von 89.51 sind zwei komplett verschiedene Zufallszahlen. Die „Gesamtdifferenz 1197", die das Notebook ausgespuckt hat, war ein Zufallswert. Ein anderes Feld hätte 40 ergeben oder 3000. Für die Aussage braucht es nur: Hash gleich oder Hash ungleich, pro Feld. Das Bild darf bleiben, als Anzeige. Als Messung war es Unsinn.
Der Diff für das Sprachmodell kam aus dem Klartext. Ich habe die Hashes gebaut, die Bilder gebaut, und dann für das Modell einen Diff aus den Original-JSONs gemacht. Da standen 89.50, PAID und das Datum drin, und die gingen an die API. Der Prompt sagte zwar „keine Werte anzeigen". Aber die Werte waren dann schon draussen. Genau das, was der Prototyp verhindern sollte, hat er im letzten Schritt selber gemacht. Wie gesagt, mit Abstand angeschaut.
SHA-256 ohne Schlüssel ist bei kleinen Wertebereichen keine Anonymisierung. Status hat vielleicht fünf mögliche Werte. Wer die kennt, hasht alle fünf und weiss sofort, was in Produktion steht. Dasselbe bei Datum, Postleitzahl, Ja/Nein, Kanton. Man braucht einen geheimen Schlüssel, der nur im Produktionssystem liegt (HMAC). Dann kann das niemand nachrechnen, auch nicht der, der die Testdaten hat.
Das ist der Grund, warum ich Prototypen liegen lasse und nochmal anschaue. Am Tag, an dem man sie baut, sieht man sie nicht.
Was der zweite Anlauf anders macht
Der zweite Anlauf hasht mit Schlüssel, vergleicht nur gleich oder ungleich, und macht eine Sache dazu, die das Argument „Produktionsdaten haben Fehler" erst richtig trägt: Vor dem Hashen wird in Stufen normalisiert.
Stufe 0, roh. Der Wert, wie er ist. Gleich? Dann ist das Feld identisch.
Stufe 1, Schreibweise. Getrimmt und kleingeschrieben. Jetzt gleich? Dann unterscheidet sich das Feld nur in Gross und Klein oder in Leerzeichen am Rand. „PAID" gegen „paid".
Stufe 2, Leerzeichen innen. Alle Leerzeichen raus. Jetzt gleich? Dann ist es eine IBAN mit und ohne Gruppierung, eine Telefonnummer mit und ohne Abstände.
Stufe 3, Rundung. Als Zahl auf zwei Stellen gerundet. Jetzt gleich? Dann ist es 89.504 gegen 89.50, ein Rundungsproblem, kein Betragsproblem.
Sonst: echt anders. Und dazu, ebenfalls ohne Wert: Typ verschieden, sieht nach Datum aus auf nur einer Seite, leer auf einer Seite.
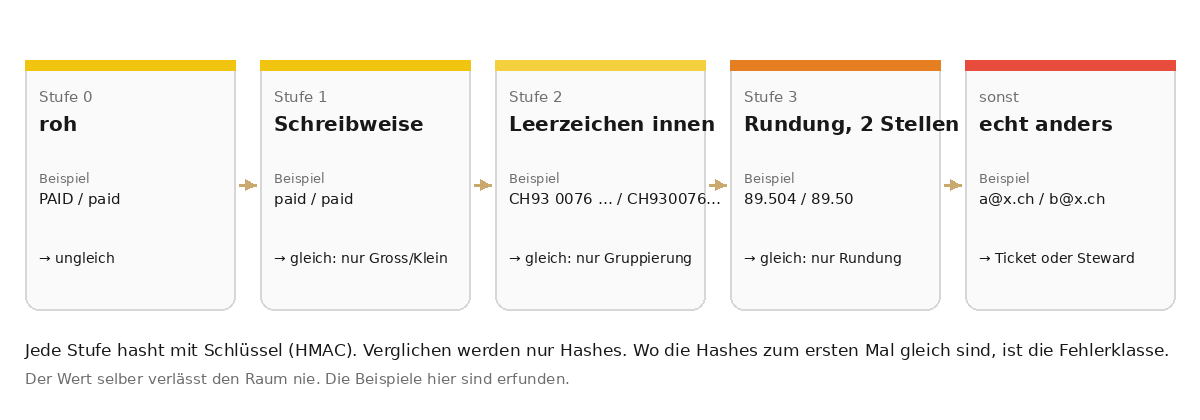
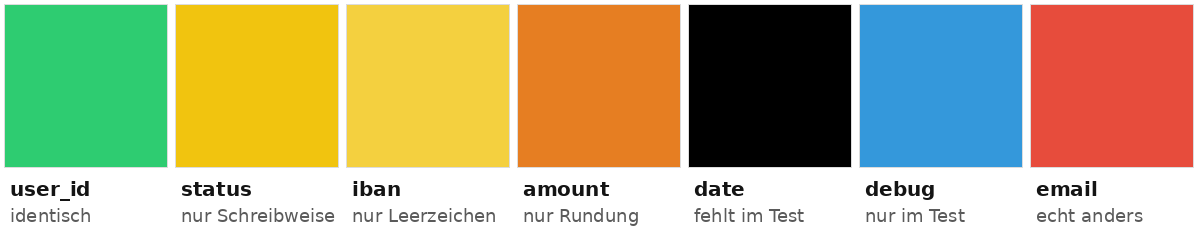
Das ist der Unterschied zum ersten Anlauf. Vorher wusste der Tester: Status ist anders. Jetzt weiss er: Status unterscheidet sich nur in Gross und Klein. Das ist ein anderer Testfall, eine andere Fehlerklasse, und er hat immer noch keinen Wert gesehen. Die Fehler, die in Produktion schlummern, kommen als Klasse raus, nicht als Kundendaten.
Was das Sprachmodell sehen darf
Der Ticket-Text kommt jetzt zuerst ohne Modell. Eine Tabelle: Feld, Befund, Hinweis. Das reicht meistens. Wenn man das Modell trotzdem will, weil es dem Tester einen Satz formuliert, bekommt es ausschliesslich diese Tabelle. Feldnamen, Befundklassen, Hinweise. Keine Werte, keine Hashes, keine Original-JSONs. Und am Ende des Notebooks steht ein Print, der zeigt, was den Rechner verlassen hat. Das ist keine Kür. Das ist der Test für den Test.
Dazu die Regel, die ich seither überall anwende: Wenn ein Prototyp Daten anonymisiert, dann muss die letzte Zeile beweisen, dass nichts anderes rausging. Nicht der Prompt. Der Code.
Einer darf schauen: die Vertrauensperson
Bis hierhin weiss der Tester, dass Status ein Schreibweise-Problem ist. Er weiss nicht, ob das ein Softwarefehler ist, ein Datenfehler in der Produktion, oder eine Erwartung, die im Test schlicht falsch war. Das weiss nur jemand, der den echten Wert sehen darf. Und die gibt es in jedem Betrieb: eine Person, oft aus der Fachabteilung, mit Zugriff auf Produktion. Die Vertrauensperson.
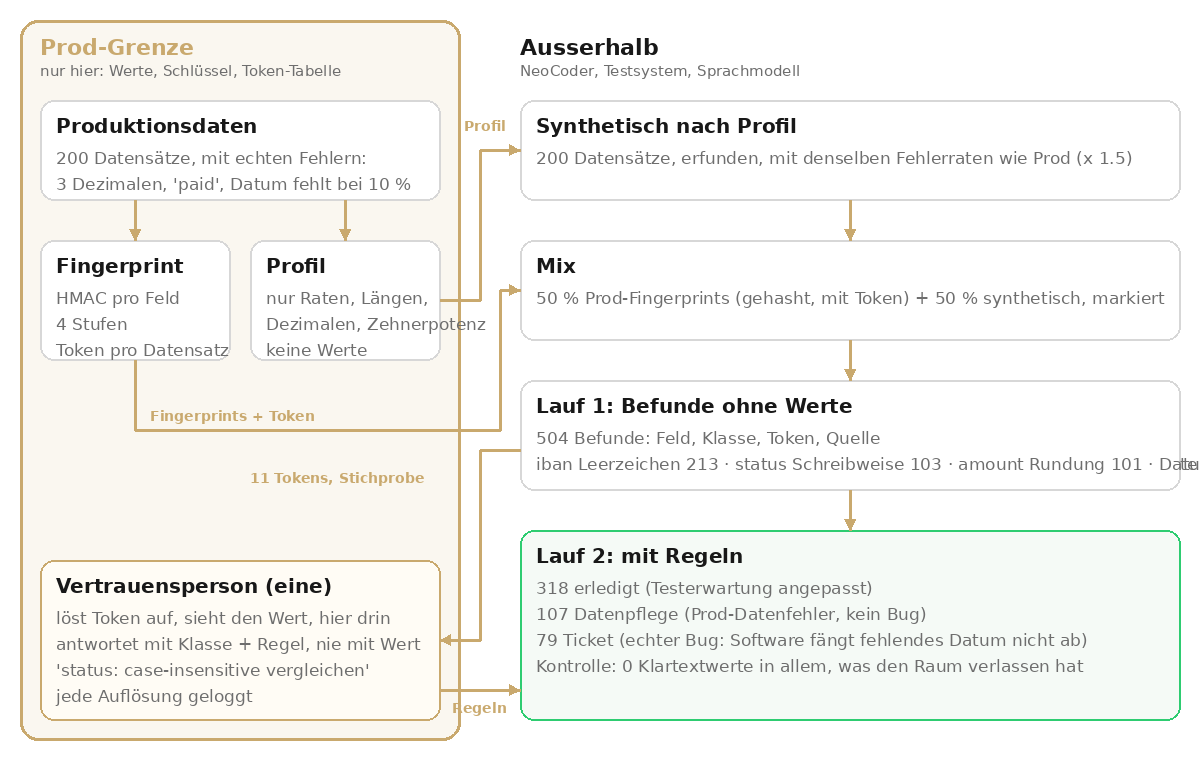
Die Vertrauensperson ist kein Zusatz. Sie ist der Teil, der das Ganze tragfähig macht. So läuft es: Jeder Befund trägt ein Token, das nur innerhalb der Produktionsgrenze auf den Datensatz auflösbar ist. Der Testlauf, oder NeoCoder, der die Tests schreibt, sieht Feld, Befundklasse, Token. Mehr nicht. Wenn eine Befundklasse neu ist, geht eine Stichprobe an die Vertrauensperson, zwei oder drei Tokens pro Feld und Klasse, nicht tausend. Sie löst sie in Produktion auf, sieht den echten Wert, und antwortet nicht mit dem Wert, sondern mit einer Klasse und einer Regel.
Testerwartung falsch. „Status ist case-insensitive zu vergleichen." Die Regel geht zurück, der Test wird angepasst, hundert Befunde verschwinden.
Datenfehler in Produktion, kein Bug. „Betrag darf nur zwei Dezimalen haben, drei kommen aus dem Altsystem." Das geht an die Datenpflege, nicht ins Ticket. Und es ist die Antwort auf die Frage, die ich jedem CTO stelle: Kennt jemand die Datenqualität? Hier ist sie, in Zahlen, ohne dass jemand einen Kunden gesehen hat.
Echter Bug. „Datum fehlt in Produktion bei rund zehn Prozent, die Software fängt das nicht ab, und der Test darf kein Datum erfinden." Das wird ein Ticket. Mit Token, ohne Wert.
Jede Auflösung wird geloggt: wer, wann, welches Token, warum. Das ist das, was der Datenschutzbeauftragte sehen will, und es ist billig, wenn man es von Anfang an einbaut. Und die Antwort der Vertrauensperson ist selber Trainingsmaterial: Die Regel gilt pro Feld und Klasse, nicht pro Datensatz. Aus drei Stichproben wird eine Regel für tausend.
Synthetisch, aber mit den Fehlern aus Prod
Und jetzt zurück zu den synthetischen Daten, die am Anfang zu sauber waren. Denn man will sie trotzdem. Mehr Daten, als Produktion hergibt. Fälle, die selten sind. Und die Möglichkeit, zu mischen, wenn man das möchte.
Der Trick ist, sie nicht sauber zu generieren, sondern nach einem Profil aus der Produktion. Das Profil misst pro Feld, ohne Werte: wie oft das Feld fehlt, wie oft es leer ist, wie die Längen verteilt sind, wie oft gross, wie oft klein, wie oft Leerzeichen am Rand, wie oft Leerzeichen innen, wie viele Dezimalstellen, welche Zehnerpotenz. Das ist Statistik, keine Kundendaten. Und daraus generiert man Datensätze, die genau diese Fehlerraten haben. Wer will, dreht die Raten hoch, anderthalbfach, doppelt, und hat einen Stresstest, der schlimmer ist als die Produktion.
Der Mix ist markiert. Jeder Datensatz weiss, ob er aus Produktion kommt oder erfunden ist. Bei den erfundenen darf NeoCoder selber in den Wert schauen, da gibt es nichts zu schützen. Bei den echten fragt er die Vertrauensperson. Und im Lauf sieht man beide nebeneinander: 213 Mal IBAN mit Leerzeichen, davon 87 aus Produktion und 126 synthetisch. Die synthetischen bestätigen, dass der Test die Klasse trifft. Die echten sagen, dass die Klasse in Produktion wirklich vorkommt.
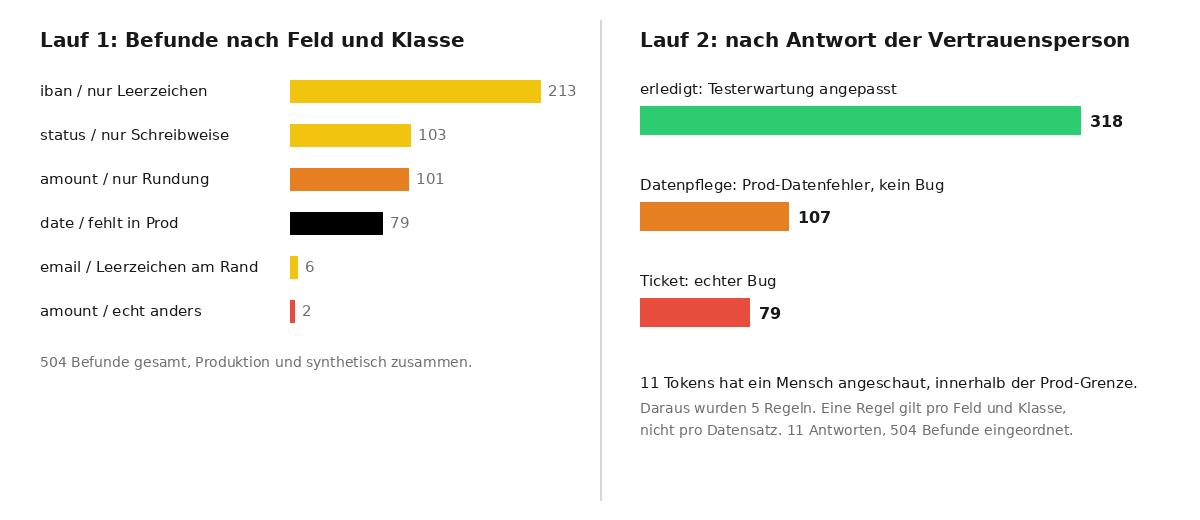
Und die Kontrolle am Ende, wieder: Was hat den Raum verlassen? Fingerprints, Tokens, Profil, Befunde. Null Klartextwerte. Beim ersten Durchlauf waren es zwei. Ich hatte im Profil Minimum und Maximum des Betrags exportiert. Das sind echte Werte. Jetzt ist es nur die Zehnerpotenz. Derselbe Fehler wie im ersten Prototyp, eine Ebene weiter. Man macht ihn immer wieder. Darum steht die Kontrolle im Code.
Wörtlich: der Testfall in Xray
So weit, so gut. Aber „amount, nur Rundung, 47 Datensätze" ist kein Ticket. Ein Tester will wörtlich wissen, wo der Fehler ist, was er tun soll, und was er sehen müsste. Und das kann nur ein System, das das Gesamtsystem kennt. Wir haben es schon einmal geschrieben, bei Code wird billig: Man kommt nie davon weg, das ganze System zu kennen. Hier ist der Beweis, an einer unscheinbaren Stelle.
Denn zum Feld „date" gehört mehr als das Feld. Welches Modul schreibt es. Welcher Writer. Welches Epic, welche Story, welcher Sprint, welcher Pull Request hat es zuletzt angefasst. Ob es aus einem Formular kommt oder aus einem Ereignis, das drei Systeme durchläuft. Das ist die System Map, und bei uns hat sie NeoCoder, weil er die Epics kennt, alle Sprints und alle Tasks, die gemacht wurden. Aus Befund plus System Map wird ein Testfall in Worten.
Was es dafür gibt, habe ich mir angeschaut. Für Jira ist Xray das Übliche, daneben Zephyr und TestRail. Xray kennt Test, Precondition, Test Set, Test Plan und Test Execution als eigene Issue-Typen, ein manueller Test hat Schritte mit Aktion, Daten und erwartetem Ergebnis, und Ergebnisse importiert man per REST als JSON: pro Test ein Status, ein Kommentar, pro Schritt ein Status und ein tatsächliches Ergebnis, dazu Beweise als Anhang. Genau das erzeugt der Prototyp jetzt: pro Befundklasse ein Test-Issue mit Schritten und ein Execution-Resultat, fertig zum Import. Ohne Wert, mit Tokens.
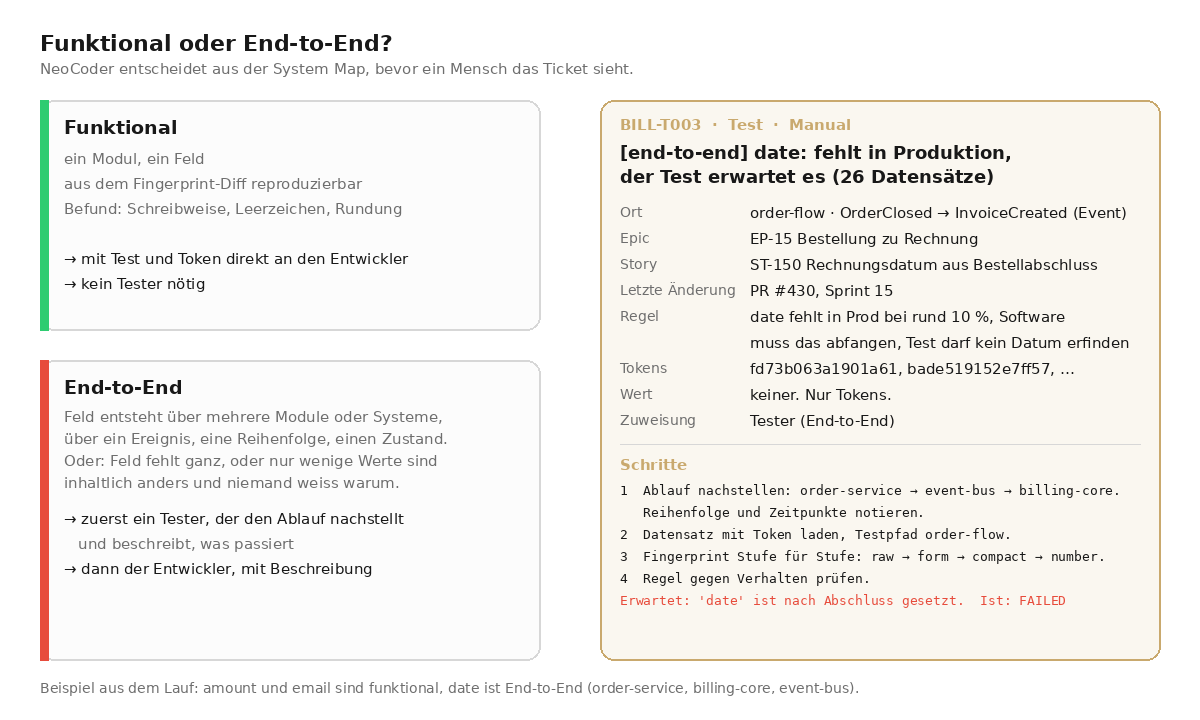
Der Ticket-Text sagt dem Tester: Feld date fehlt in Produktion, der Test erwartet es. Vermutete Ursache: Software fängt fehlendes Feld nicht ab. Ort: order-flow, geschrieben vom Ereignis OrderClosed nach InvoiceCreated, Epic EP-15, Story ST-150, zuletzt geändert in PR 430 im Sprint 15. Regel: Datum fehlt in Prod bei rund zehn Prozent, Software muss das abfangen. Das ist wörtlich. Damit geht jemand hin und findet die Stelle in einer Viertelstunde statt in einem Tag.
Funktional oder End-to-End?
Und dann die Frage, die am meisten Zeit spart, wenn man sie vor dem Ticket beantwortet: Kann ich das direkt einem Entwickler geben, oder braucht es zuerst einen Tester, der es nachstellt und beschreibt, was passiert?
Die Testwelt unterscheidet das seit Jahrzehnten, Komponententest, Integrationstest, Systemtest, Abnahmetest, und in der Praxis läuft es auf zwei Fragen hinaus. Ist der Fehler in einem Modul, an einem Feld, und aus dem Fingerprint-Diff deterministisch reproduzierbar? Dann ist er funktional. Test und Token gehen direkt an den Entwickler, ein Tester dazwischen würde nur wiederholen, was der Diff schon sagt. Oder entsteht das Feld über mehrere Module oder Systeme, über ein Ereignis, eine Reihenfolge, einen Zustand? Dann ist er End-to-End. Da muss zuerst ein Mensch den Ablauf nachstellen und beschreiben, was passiert, weil der Diff nur sagt, dass am Ende etwas fehlt, nicht wo unterwegs.
Funktional. Schreibweise, Leerzeichen, Rundung, ein Modul. Im Lauf: amount aus billing-core, email aus customer-master. Direkt an den Entwickler, mit Testfall und Token. Kein Tester.
End-to-End. Ein Feld, das über order-service, event-bus und billing-core entsteht. Im Lauf: date. Zuerst ein Tester, der den Ablauf nachstellt, dann der Entwickler, mit der Beschreibung. NeoCoder setzt den ersten Schritt des Testfalls entsprechend: „Ablauf nachstellen, Reihenfolge und Zeitpunkte notieren."
Unklar. Wenige Datensätze, echt anders, keine Regel. Auch das ist End-to-End, aus einem anderen Grund: Man weiss nicht, was passiert ist. Das darf man nicht einem Entwickler ins Backlog legen. Das schaut sich jemand an.
Die Entscheidung trifft NeoCoder aus der System Map, bevor ein Mensch das Ticket sieht. Sie steht im Titel, in eckigen Klammern, und in der Zuweisung. Das ist nicht viel Code. Es ist die Information, die in den meisten Betrieben in keinem Ticket steht und die jeder Tester am Anfang erst herausfinden muss.
Und die DSGVO?
Ich bin kein Jurist, und am Ende nimmt das der Datenschutzbeauftragte des Kunden ab. Aber drei Dinge muss man auseinanderhalten, und der Aufbau setzt sie um.
Die Fingerprints mit Schlüssel sind Pseudonymisierung, nicht Anonymisierung. Solange der Schlüssel existiert, sind es für den, der ihn hat, Personendaten. Das ist kein Nachteil: Pseudonymisierung ist genau die Massnahme, die die DSGVO empfiehlt, und für den, der den Schlüssel nicht hat, also das Testsystem, NeoCoder, das Modell, sind die Daten praktisch nicht zuordenbar. Ich würde es trotzdem intern als pseudonymisiert führen, nicht als anonym. Ehrlich ist sicherer.
Das Profil und die Befundklassen sind Statistik. „Zehn Prozent ohne Datum" hat keinen Personenbezug, wenn die Gruppe gross genug ist. Bei fünf Datensätzen wäre auch eine Statistik ein Wert, darum gehört eine Mindestgrösse rein. Die synthetischen Daten daraus sind anonym, es gab nie eine Person dahinter. Und das Sprachmodell bekommt Feldnamen und Klassen, also gar keine Personendaten.
Die Vertrauensperson ist die einzige Stelle, an der ein Mensch einen Wert sieht: innerhalb der Produktion, für einen dokumentierten Zweck, geloggt. Das ist Zweckbindung, Datenminimierung und Nachweis in einem. Was noch fehlt, bevor ein Kunde das abnimmt, ist Papier und Betrieb, nicht Code: die Rechtsgrundlage für den Zugriff der Vertrauensperson, ein Eintrag im Verarbeitungsverzeichnis, und die Frage, wo der Schlüssel liegt und wer ihn rotiert.
Was bleibt
Der Prototyp sind drei Module mit ein paar hundert Zeilen: Vergleich, Vertrauensperson, Synthetik, Xray. Er löst das Problem nicht für alle, aber er zeigt, dass es geht: Produktion gegen Test vergleichen, automatisiert, schnell, mit den echten Fehlern aus der Produktion, ohne dass ein Mensch oder ein Modell je einen Kundenwert sieht. Das ist für viele Betriebe der Unterschied zwischen „wir testen mit dem, was wir uns ausdenken" und „wir testen mit dem, was wirklich passiert".
Und der Fehler im ersten Anlauf bleibt als Erinnerung. Ich habe ein System gebaut, das Daten schützt, und im letzten Schritt die Daten rausgeschickt. Nicht, weil ich es nicht wusste. Sondern weil ich am Ende des Tages noch schnell den schönen Teil bauen wollte, den Satz für das Ticket. Der schöne Teil ist immer der, bei dem man aufhört zu prüfen.
Synthetische Daten sind sauber, und sauber ist nicht, was man testen muss. Hashes mit Schlüssel und Vergleich in Stufen zeigen, wie sich Produktion vom Test unterscheidet, ohne einen Wert zu zeigen. Eine Vertrauensperson sagt, was der Unterschied bedeutet, mit einer Regel, nicht mit dem Wert. Synthetische Daten nach Profil bringen die Produktionsfehler in den Test, ohne die Produktion. Und das Modell bekommt nur die Tabelle. Die letzte Zeile im Code beweist es. Nicht der Prompt.
Geschrieben von mir. Die Gedanken, die Werte, die Learnings, die Fehler: alles meins. Grammatik und Rechtschreibung korrigiert unser eigenes Twin-Modell, das auf meinen Texten trainiert ist. Manchmal bleibt ein Hüpfer drin. Das ist dann auch von mir.