Jetzt mal ganz ehrlich: Bevor wir über Agenten und NeoCoder geredet haben, haben wir einen Kühlschrank gebaut. Er hiess SKIMO, kam aus Zug, lief produktiv ohne ein einziges Modell, und er war der Schritt vom kleinen zum grösseren Modell. Daneben hatten wir Object Recognition gemacht, ein Modell, das ein Bild anschaut und sagt, was es sieht. Bei SKIMO haben wir zum ersten Mal versucht, aus Daten die Zukunft zu lesen. Das Jupyter Notebook von damals habe ich noch. Es ist vom 4. Dezember 2019, und wenn ich es heute anschaue, sehe ich vor allem eines: Da waren wir am Anfang.
Das Problem mit dem Automaten
Ein Verkaufsautomat ist ein seltsames Ding. Er steht seit Jahrzehnten überall, und trotzdem weiss niemand, was in ihm passiert. Wer kauft was, wann, wie oft. Was liegt seit drei Wochen drin. Was fehlt seit gestern. Jeder Online-Shop kennt jeden Klick. Der Automat war ein schwarzes Loch.
Das war der Ausgangspunkt. Nicht „wir wollen KI machen". Sondern: Ein Kasten mit Essen drin sollte endlich wissen, was er tut.
Was SKIMO war
SKIMO war ein smarter Kühlschrank, ein smarter Schrank, und die Software dahinter. Online, Offline und Logistik in einem Produkt, so haben wir es damals genannt.
Der Endkunde kommt an den Kühlschrank, die App merkt per Nähe, vor welchem SKIMO er steht, kein Barcode, kein QR-Code. Ein Klick, der Kühlschrank öffnet sich. Man nimmt raus, was man will, schliesst, fertig. Bezahlt wird im Hintergrund. Die App zeigt Produkte, Nährwerte, Favoriten, was noch da ist und was nicht mehr.
Auf der anderen Seite: eine App für die Leute, die nachfüllen, Schritt für Schritt geführt. Ein Backend für Logistik und Planung. Ein Dashboard mit allem, was gekauft wurde. Und ein Kreislauf, der so aussah:
280 Produkte, jede Bewegung
Wie weiss ein Kühlschrank, was rausgenommen wurde? Nicht mit einer Kamera. Mit Tags. Jedes Produkt hatte einen RFID-Tag, und der Kühlschrank hat gelesen, was drin liegt und was sich bewegt. Über 280 verschiedene Produkte konnten wir so erkennen. Nicht nur „ist da" oder „ist weg", sondern die Bewegung: Was wurde rausgenommen, was wieder zurückgelegt, was hat jemand angeschaut und dann doch nicht gekauft.
Das klingt heute unspektakulär. Damals war es die Grundlage für alles, was danach kam. Zum ersten Mal hatten wir nicht nur einen Kassenbon. Wir hatten das Verhalten vor dem Kauf. Zu jeder Tageszeit, an jedem Standort, für jedes Produkt.
Die Zahlen aus dem ersten Jahr
Seit Januar 2019 waren wir live. Erster Kunde: ein Schweizer Anbieter für gutes Essen in Büros. Zehn Standorte, Kühlschränke in Pausenräumen.
85 Prozent Wiederkäufer innerhalb einer Woche. Das ist die Zahl, die mir geblieben ist. Die Leute haben es benutzt, ohne dass man es ihnen erklären musste. Ein Klick, Tür auf. 2020 waren wir damit an der CES in Las Vegas, danach kamen Gespräche mit der Post und dem Detailhandel, 2022 lief ein weiterer Test.
Das Notebook vom Dezember 2019
Wichtig, bevor es weitergeht: SKIMO 1 ist komplett ohne Modell produktiv gegangen. Live-Inventar, Regeln, Prozesse, das hat den Betrieb getragen. Was jetzt kommt, war eine Studie nebenbei. Wir sassen da mit den Daten. 280 Produkte, zehn Kühlschränke, hunderte Nutzer, jede Bewegung mit Zeitstempel. Und die Frage: Kann man daraus vorhersagen, was nächste Woche gegessen wird? Wann isst jemand Reis statt Nudeln, bei Regen oder bei Sonne? Was geht am Montag, was am Freitag? Was soll der Koch nächste Woche kochen, und wie viel?
Ich habe das Notebook noch. 44 Seiten. Und es ist ehrlich gesagt ein Zeitdokument dafür, wie man anfängt, wenn man noch nicht weiss, wie es geht.
Wir haben die Daten aus der MongoDB gezogen und in pandas geladen. Wir haben Produktnamen per Hand bereinigt, weil „Sandwich Chicken Barbecue" und „Sandwich Turkey Barbecue" für das Modell zwei völlig verschiedene Dinge waren. Wir haben Random Forest, Gradient Boosting und ein LSTM ausprobiert, um zu sehen, welcher Ansatz überhaupt greift. Wir haben PySpark auf einem Laptop mit 24 Gigabyte Executor-Speicher hochgefahren, weil wir dachten, das brauche man so. Und am Ende hat ein klassisches SARIMA-Modell mit Wochensaisonalität den besten Forecast geliefert, mit Vorhersagen, die über den ganzen Testzeitraum im 95-Prozent-Konfidenzintervall lagen.
Die wichtigsten Merkmale laut Entscheidungsbaum: der Produktname, die Kalenderwoche, der Preis. Dahinter, mit weniger Gewicht, ob ein Produkt vegetarisch war und in welchem Kühlschrank es lag. Und in den Verkaufskurven sah man eine Saisonalität von etwa drei Monaten.
Das Fazit im Notebook, in roter Schrift: Die Verkäufe zeigen ein Muster, das gut vorhersagbar ist. Also lässt sich später ein Optimierer bauen, der Food Waste minimiert und Verkäufe maximiert. Genau das, was wir wollten.
Was die Daten uns gesagt haben
Aber die Überschrift direkt darunter war die wichtigere. Sie hiess: Warum die aktuellen Daten nicht vorhersagbar sind. Und dann kamen drei Punkte, die ich heute fast wörtlich in jedem ersten Gespräch mit einem CTO wiederhole.
Die Daten waren inkonsistent, und es gab kaum Beziehungen zwischen ihnen. Wir hatten eine Dokumentendatenbank gewählt, weil wir am Anfang nicht wussten, welche Daten wir haben würden. Für die Auswertung war das die falsche Entscheidung. Das Notebook empfiehlt SQL oder eine Graphdatenbank, und zeichnet den Graphen gleich auf: Nutzer, Kühlschrank, Produkt, Produkttyp, Kategorie, aktiver Bestand. Das waren noch Zeiten. Heute ist das anders: Ein Sprachmodell liest die unsauberen Dokumente, findet die Beziehungen selber, und Embeddings machen aus „Sandwich Chicken Barbecue" und „Sandwich Turkey Barbecue" Nachbarn, ohne dass jemand ein Schema zeichnet. Die Dokumentendatenbank wäre heute kein Problem mehr. Die Frage wäre eine andere: nicht welche Datenbank, sondern ob die Daten gut genug sind, dass ein Modell sie versteht.
Es gab keine Kategorien auf der richtigen Ebene. Jedes Sandwich war ein eigenes Produkt. Das Modell konnte nicht lernen, dass Menschen „ein Sandwich" wollen und nicht „das Sandwich mit der ID 4711". Ohne Kategorien war jeder Zusammenhang zwischen ähnlichen Produkten für das Modell unsichtbar.
Es gab keine Dokumentation des Bestands. Wenn ein Produkt in einer Woche nicht verkauft wurde, konnte niemand sagen, ob es keiner wollte oder ob es einfach nicht im Kühlschrank lag. Das Modell hat aus „nicht angeboten" gelernt „keine Nachfrage". Und es gab keine Möglichkeit vorherzusagen, was der Koch gerade Lust hatte zu kochen.
Das war 2019. Wir hatten ein Modell, das funktionierte, und Daten, die es nicht verdient hatten. Kein grosses Modell, keine GPU, kein neuronales Netz, das am Ende gewonnen hat. Ein Zeitreihenmodell aus den Siebzigern und die Erkenntnis, dass die Arbeit nicht im Modell liegt, sondern davor.
Was man heute besser machen würde
Wenn ich das Notebook heute aufmache, ist es, wie in die eigene Kindheit zurückzugehen. Man erkennt sich, man ist ein bisschen stolz, und man fasst sich an den Kopf.
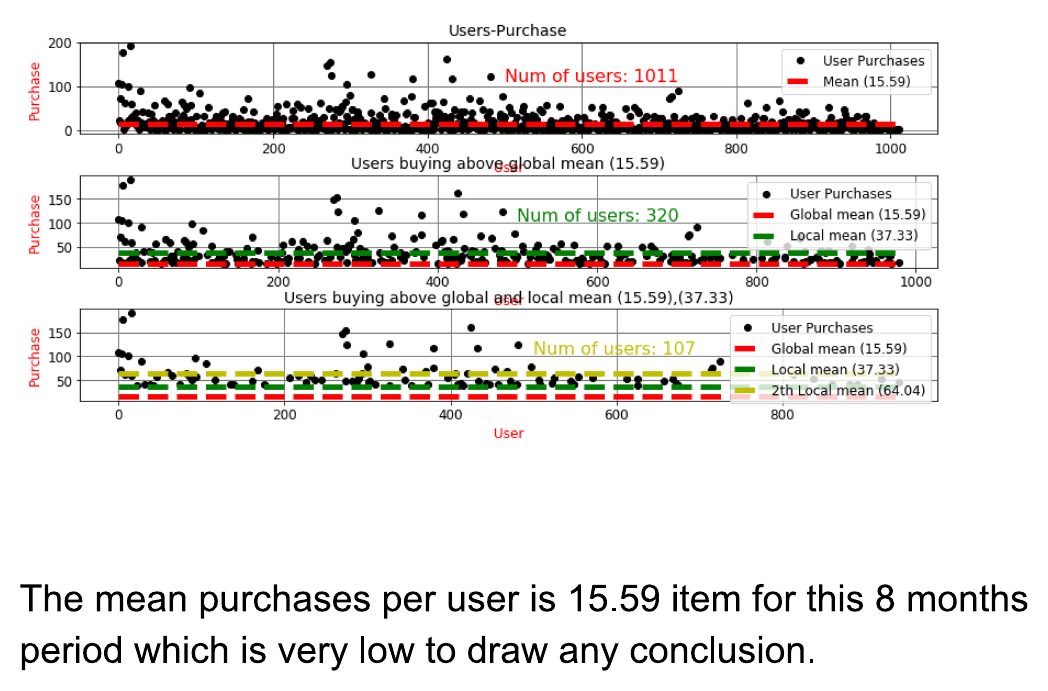
PySpark mit 24 Gigabyte Executor-Speicher auf einem Laptop, für ein paar zehntausend Zeilen. Das geht heute in pandas in einer Sekunde, und damals wäre es auch gegangen. Ein LSTM für Daten, bei denen im Schnitt 15 Käufe pro Person vorliegen. Produktnamen per Hand bereinigen, in einer Funktion mit sieben Replace-Aufrufen. Und der grösste Punkt: Wir haben die Daten monatelang gesammelt und erst danach überlegt, welche Struktur sie bräuchten.
Datenmodell zuerst. Kategorien, Bestand als Ereignis, Beziehungen zwischen Nutzer, Kühlschrank und Produkt. Heute steht das vor der ersten Zeile Code. Damals nach neun Monaten Betrieb in einem Notebook als Vorschlag.
Bestand als Ereignis, nicht als Zustand. Rein, raus, zurückgelegt, abgelaufen, jeweils mit Zeitstempel. Dann weiss man, ob ein Produkt nicht verkauft wurde, weil es niemand wollte, oder weil es nicht drin lag. Genau die Frage, die das Modell damals nicht beantworten konnte.
Kategorien von einem Modell, nicht von Hand. Das Zuordnen von „Sandwich Chicken Barbecue" zu „Sandwich" ist heute genau das, was unser Modell mit den 900 Kategorien macht. Embeddings für die Vorauswahl, ein Sprachmodell für die Entscheidung. 2019 gab es das so nicht. Wir haben es Jahre später gebaut, und die Wurzel liegt hier.
Vorhersage pro Kategorie, nicht pro Produkt. „Sandwiches gehen am Montag" ist eine Aussage, mit der ein Koch etwas anfangen kann. „Produkt 4711 geht am Montag" ist Rauschen.
Ein fester Testsatz und ein Protokoll. Welche Daten, welche Version, welches Ergebnis. Im Notebook stehen die Zellen in der Reihenfolge, in der wir sie ausgeführt haben, und niemand könnte sie heute nachvollziehen. Das ist der Unterschied zwischen einer Studie und einem System.
Und ganz einfach: mehr Daten, bevor man mehr Modell nimmt. Die Notiz unter dem Diagramm war die klügste Zeile im ganzen Notebook. 15 Käufe pro Person reichen nicht. Kein Modell der Welt macht daraus eine Vorhersage. Man muss länger sammeln, sauberer sammeln, und dann rechnen.
Das Schöne daran: Nichts davon ist heute schwer. Alles davon ist heute Standard, in jedem Projekt, bevor jemand von KI spricht. Und dass wir es wissen, liegt daran, dass wir es damals nicht wussten.
Was davon geblieben ist
Dass die Daten das Produkt sind. Der Kühlschrank war die Hardware, die App war die Oberfläche, aber das, was am Ende zählte, war die Reihe von Bewegungen mit Zeitstempel. Und dass man diese Daten von Anfang an so ablegen muss, dass man sie später auswerten kann. Kategorien, Bestand, Beziehungen. Nicht erst, wenn jemand die Frage stellt.
Dass die Frage vor dem Modell kommt. „Was geht nächste Woche" ist eine gute Frage. „Zeig mir alles" ist keine. Das ist heute die erste Frage in jedem Projekt: Welche Entscheidung soll besser werden?
Und dass der Schritt vom kleinen zum grösseren Modell nicht ein Schritt in der Technik ist, sondern in der Frage. Object Recognition beantwortet „was ist das". Eine Vorhersage beantwortet „was wird sein". Das zweite braucht nicht mehr Rechenleistung. Es braucht bessere Daten und eine klarere Frage. Das beste Ergebnis im Notebook kam nicht vom LSTM, sondern von SARIMA. Alles, was danach kam, die eigenen Modelle, die 900 Kategorien, NeoCoder, hat auf dieser Erfahrung aufgebaut: Erst die Daten, dann die Frage, dann das Modell. Nicht umgekehrt.
Man fängt nicht mit KI an, weil man es will. Man fängt an, weil man Daten hat und eine Frage, die sich damit beantworten lässt. Bei uns war es ein Kühlschrank in einem Pausenraum und ein Notebook mit 44 Seiten, das uns gesagt hat, was wir noch nicht wussten. Was war es bei dir?
Geschrieben von mir. Die Gedanken, die Werte, die Learnings, die Fehler: alles meins. Grammatik und Rechtschreibung korrigiert unser eigenes Twin-Modell, das auf meinen Texten trainiert ist. Manchmal bleibt ein Hüpfer drin. Das ist dann auch von mir.