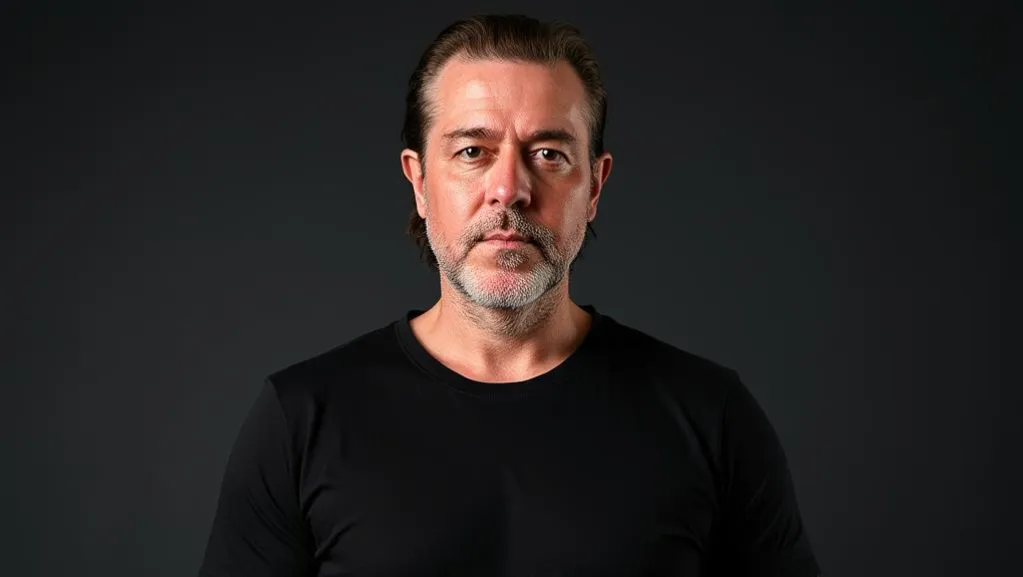
Ok, zugegeben: Das hier ist Spielzeug. Ich konnte es euch trotzdem nicht vorenthalten. Für den Podcast brauchte ich ein Gesicht, das spricht, und ich wollte nicht jedes Intro selber vor die Kamera stehen. Also ein Avatar. Aus einem einzigen Foto. Was als Wochenendidee anfing, wurde eine kleine Studie darüber, wie ein Modell Python-Scripts schreibt, um ein Ziel zu erreichen, und wo ein Mensch, der anno in Maya Knochen gesetzt hat, eingreifen muss, damit es sauber wird.
Wie es dazu kam
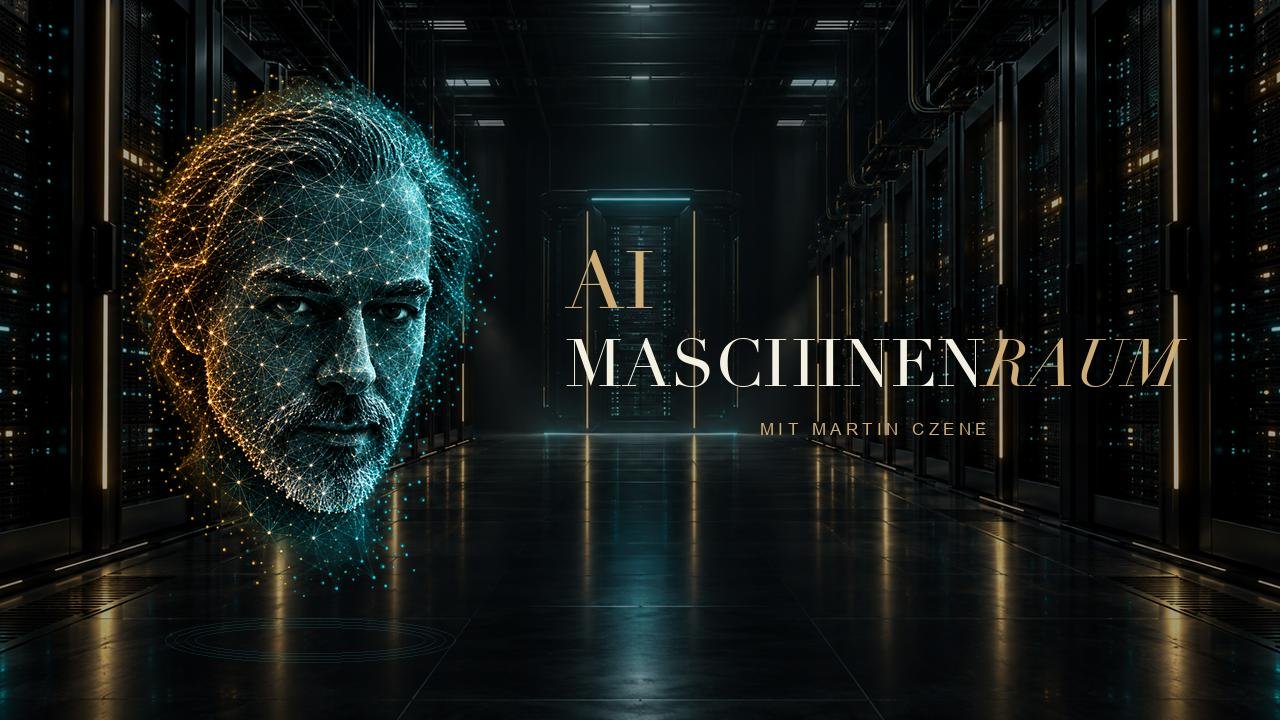
Der Podcast heisst AI Maschinenraum. Ich wollte ein Intro, das nach Maschinenraum aussieht: ein Serverraum, ein Titel, und ein Kopf, der aus Punkten besteht und trotzdem ich ist. Der Kopf sollte sprechen können, blinzeln, zwinkern. Und er sollte aus einem Foto entstehen, nicht aus einem 3D-Scan, weil ich keinen Scanner habe und weil die Frage mich interessiert hat: Wie weit kommt man mit einem Bild?
Fakt ist: Fertige Tools dafür gibt es. Man lädt ein Foto hoch, bekommt ein Video zurück. Aber dann weiss ich nicht, was passiert, meine Daten liegen irgendwo, und ich lerne nichts. Das ist nicht der Maschinenraum. Also haben wir es selber gebaut, lokal, ohne dass ein Bild den Rechner verlässt.
Warum es eine Studie ist und kein Produkt
Der eigentliche Zweck war nicht der Avatar. Der Zweck war zu sehen, wie ein Modell arbeitet, wenn man ihm ein Ziel gibt, das mehrere Schritte braucht: Foto rein, Gesichtspunkte finden, ein 3D-Gitter anpassen, einen Kiefer aufhängen, Muskeln nachbilden, Mundformen zu Lauten, das Ganze im Browser rendern. Das Modell schreibt Python-Scripts. Eines nach dem anderen. fit_face_rig.py, face_rig_3d.py, face_performance.py, render_rig_review.py, export_live_avatar.py. Jedes Script ein Schritt, jeder Schritt prüfbar.
Und am Ende steht ein Mini-Modell, das mit einem Foto einen solchen Avatar ziemlich gut bewegen kann. Nicht perfekt. Ziemlich gut. Für ein Podcast-Intro reicht das. Für einen Kunden nicht, und das steht auch so in der README, damit es niemand verwechselt.
Ein Foto, 468 Punkte
Der erste Schritt ist der einfachste und der, bei dem am meisten schiefgeht. Aus dem Foto werden 468 Gesichtspunkte gemessen, Landmarks, mit einem lokalen Modell von Google MediaPipe. Dazu kommt eine kanonische Gesichtstopologie, ein fertiges Netz, das weiss, welche Punkte zusammengehören: Augenlider, Lippen, Nasenflügel. Man legt es über die gemessenen Punkte, und schon hat man ein Gesicht in drei Dimensionen. Die Tiefe ist geschätzt, aus einem Bild, das muss man wissen. Es ist kein Scan.
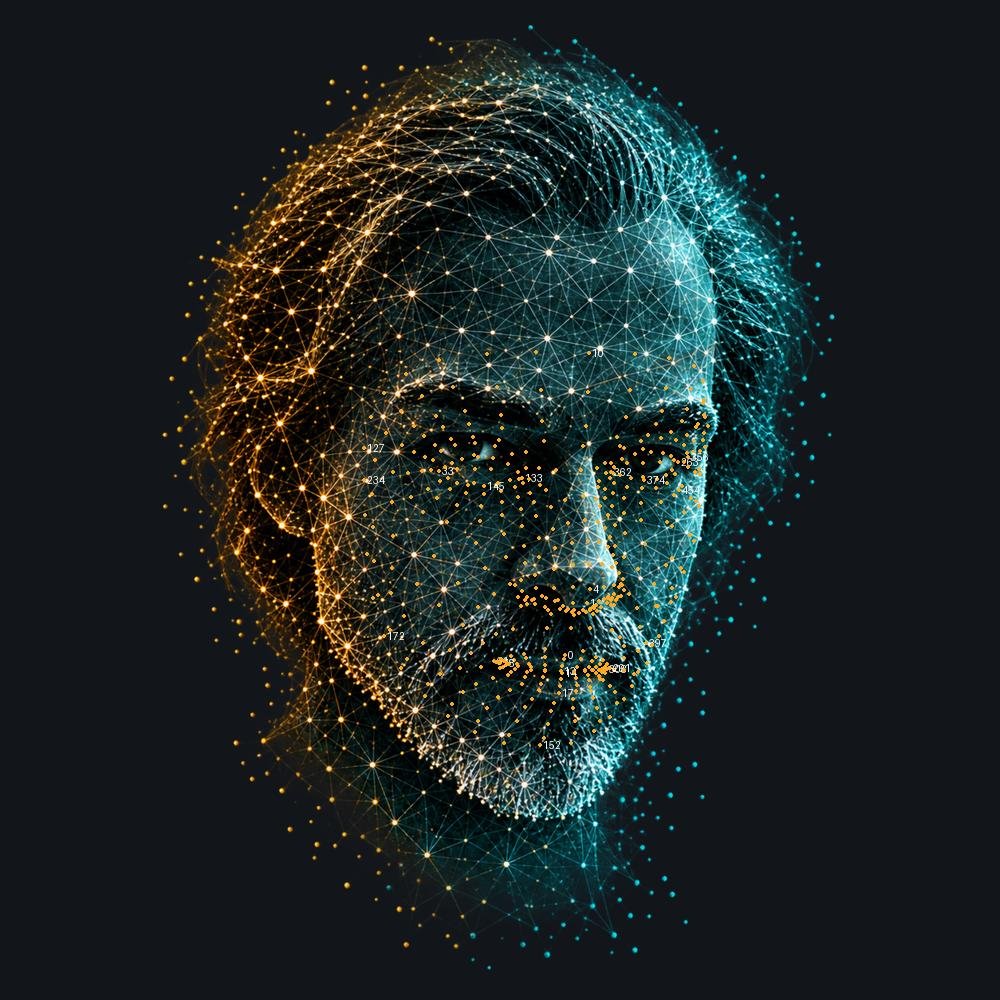
Und genau das ist passiert. Das Foto, das ich verwendet habe, ist stilisiert, ein leuchtendes Gitter über dem Gesicht. Das hat die automatischen Augenpunkte nach unten gezogen. Das Modell hat es nicht gemerkt. Ich schon, beim Anschauen der Prüfansicht. Also gibt es im Script eine Stelle mit vierzehn von Hand gesetzten Ankern, Lidkanten und Lippenränder, und eine Thin-Plate-Spline-Korrektur, die den Rest des Netzes mitzieht. Einmal, beim Ruhezustand. Danach stimmt es.
Der Kiefer ist ein Knochen, der Rest ist Haut
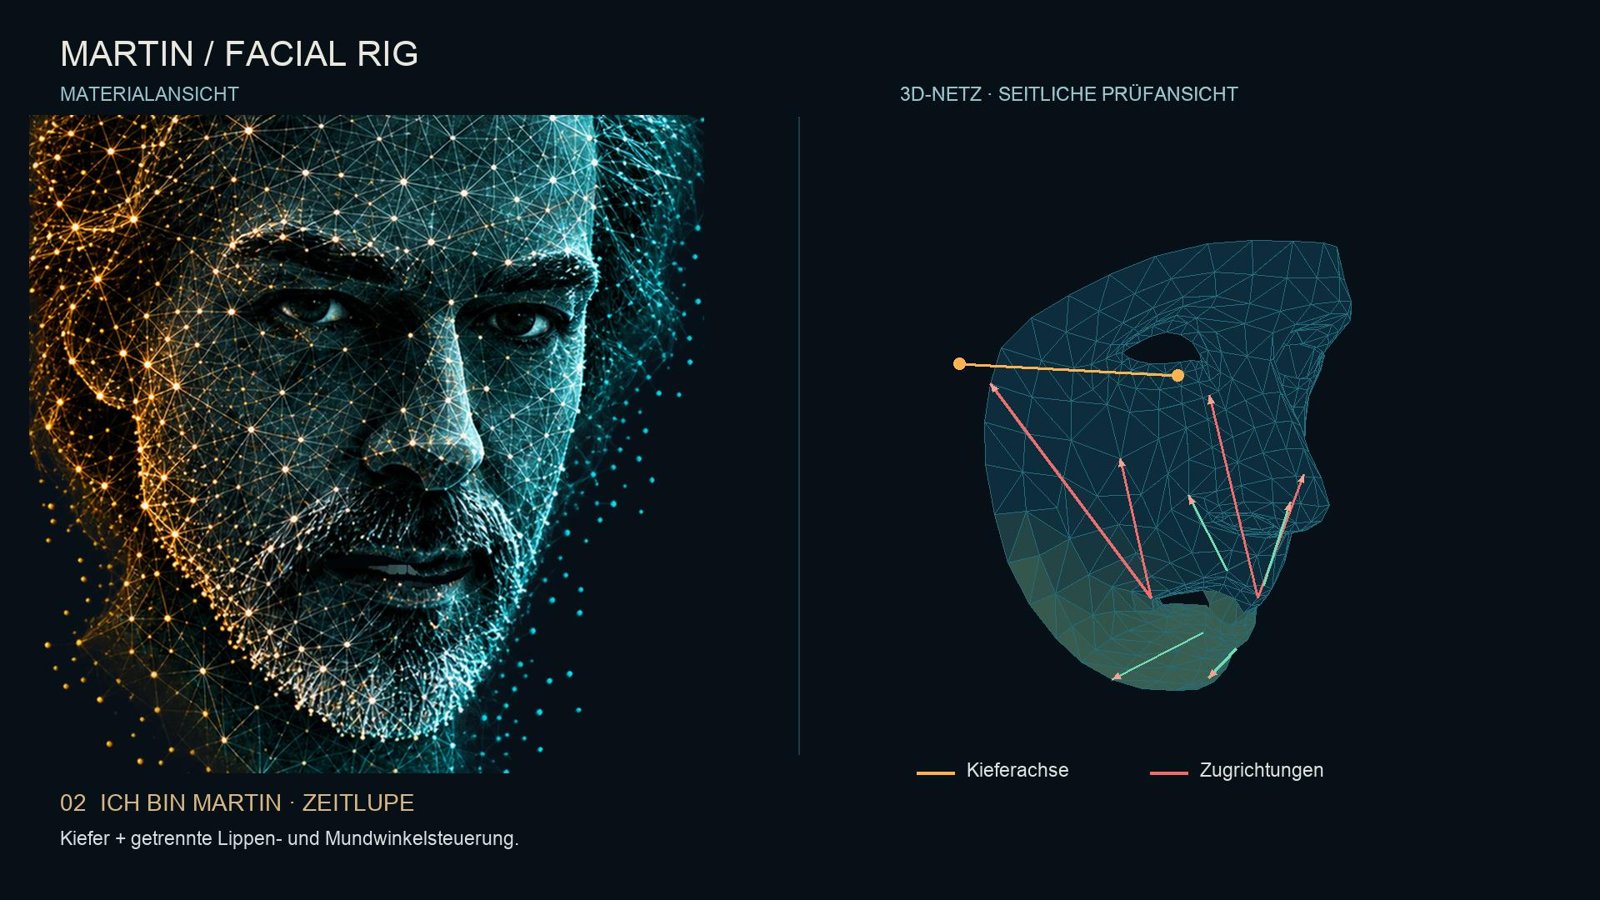
Hier wird es interessant, und hier kam die Erfahrung ins Spiel. Ein Gesicht, das spricht, ist zum grössten Teil ein Kiefer, der sich dreht. Nicht der Mund, der auf und zu geht, sondern der Unterkiefer, der um eine Achse hinter den Ohren rotiert, und die Haut, die daran hängt. Wer das als Verschiebung von Mundpunkten baut, bekommt einen Fisch. Wer es als Knochen baut, bekommt ein Gesicht.
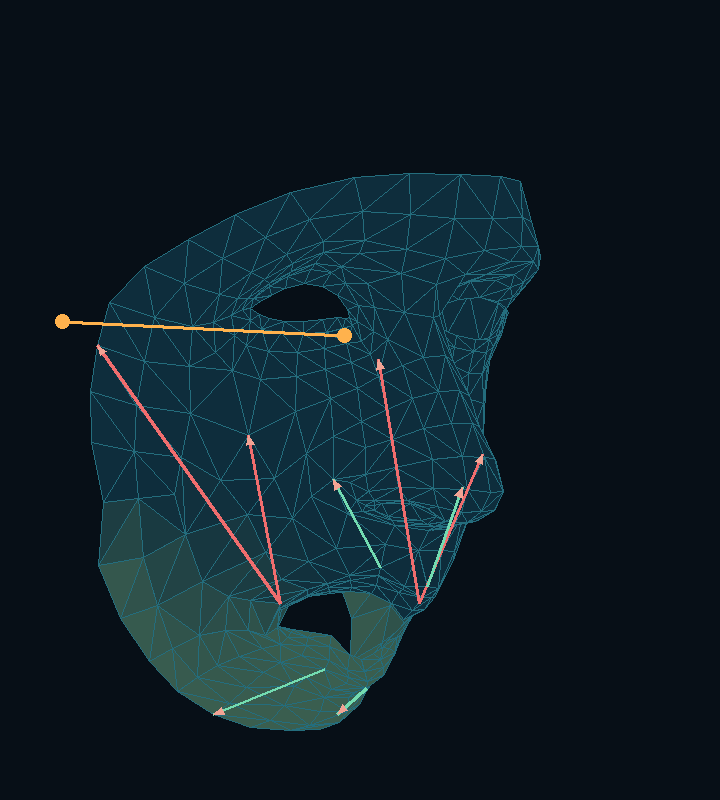
Im Script steht die Achse als zwei Punkte, links und rechts, von den Ohrpunkten aus versetzt: 18 nach unten, 45 nach hinten. Das sind keine Messungen an meinem Schädel. Das sind Werte, die ich so lange verschoben habe, bis der Kiefer in der Prüfansicht richtig fiel. Dann kommt der Teil, den das Modell gut kann: Jeder Punkt des Netzes bekommt ein Gewicht zwischen null und eins, wie stark er dem Kiefer folgt. Die Lippen unten eins, die Nase null, dazwischen weich. Das rechnet ein harmonisches Feld auf dem Gitter, eine Laplace-Gleichung mit festen Rändern. Kinn und Bart hängen am Kiefer. Die Haare seitlich am Schädel. Der Hals an gar nichts.
Was Maya uns anno beigebracht hat
Ich habe das schon einmal gemacht. Anno, in Maya, mit Bones und Skin Weights, von Hand, Punkt für Punkt gemalt. Wer das einmal gemacht hat, vergisst zwei Dinge nie: Ein Bone gehört dorthin, wo das Gelenk wirklich ist, nicht dorthin, wo es im Bild aussieht. Und ein Gitter muss sauber sein, bevor man es bewegt. Ein Dreieck, das über die Lippenkante läuft, reisst beim ersten Öffnen des Mundes.
Beides hat das Modell zuerst falsch gemacht. Die Kieferachse lag zu weit vorne, am Mundwinkel, weil dort die Punkte sind. Und das Netz hatte keine Trennung zwischen Ober- und Unterlippe, der Mund war ein geschlossenes Loch. Ich habe es nicht selber umgeschrieben. Ich habe gesagt, wo es falsch ist und warum, so wie man es einem Junior sagt, der zum ersten Mal riggt. Dann kam das nächste Script, mit der Achse hinter den Ohren und mit einer eigenen Innenkante für den Mund. Und die Muskeln: Risorius, Zygomaticus, Levator, Depressor, Mentalis, als Zugrichtungen zwischen Ansatzpunkten, mit einem Abfall entlang der Kanten des Gitters, nicht als Kugel im Raum. Sonst zieht das Lächeln die Nase mit.
War schon etwas Aufwand. Mehr, als ich am Anfang dachte. Aber die Korrekturen waren immer dieselben zwei: Wo ist der Knochen wirklich, und ist das Gitter sauber. Wer das im Kopf hat, kann ein Modell dorthin führen.
Zwölf Mundformen und eine Uhr
Sprechen ist dann nicht mehr schwer, wenn der Kiefer stimmt. Es gibt zwölf Mundformen, Viseme: Ruhe, A, E, I, O, U, M-B-P, F-V, L-N-T-D, CH-SCH, S-Z, K-G. Jede ist eine Mischung aus Kieferwinkel und Formzielen. Und es gibt eine Regel, die wichtiger ist als jede Mundform: Es gibt nur eine Uhr, und das ist die Audio-Uhr. Jede Mundform wird auf die Zeit des Tons geplant, nicht auf einen Timer im Browser. Sonst driftet es nach dreissig Sekunden, und dann stimmt kein M mehr auf einen Lippenschluss.
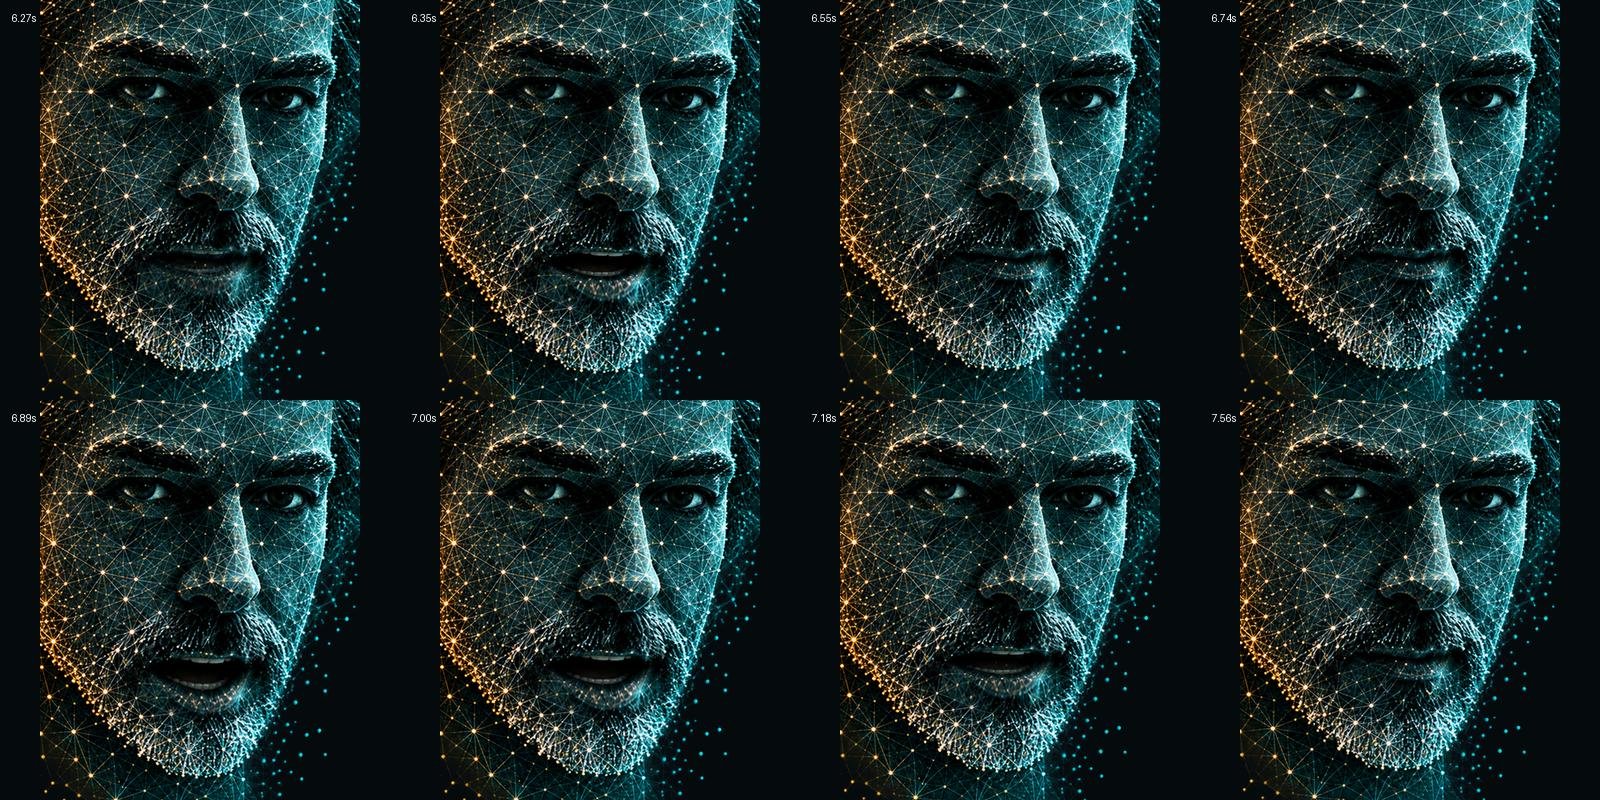
Die Stimme kommt als Stream von einem TTS-Anbieter, mit Zeitmarken pro Zeichen. Die Zeichen werden zu angenäherten deutschen Mundformen, sch, ch und Doppellaute zusammengefasst. Das ist keine Phonemerkennung, das steht auch so in der Doku, und man sieht es bei schnellen Sätzen. Für die nächste Stufe hängt man einen richtigen Visem-Provider an dieselbe Schnittstelle. Der Schlüssel für den Anbieter liegt auf dem Server, nie im Browser. Auch bei Spielzeug.
Die Stirn darf nicht tot sein
Nach dem Mund war das Gesicht zwar richtig, aber tot. Ein Mensch, der spricht, bewegt die Stirn. Also drei weitere Formziele, nach dem Schema, das Animatoren FACS nennen: innere Braue hoch, äussere Braue hoch, Brauen runter. Links und rechts getrennt, weil kein Gesicht symmetrisch ist. Ein leiser Idle, wenn er nichts sagt, mit eigener Phase pro Seite, damit sie nie im Gleichschritt gehen. Und beim Sprechen nur eine leichte Überlagerung: ein M senkt links etwas, ein O hebt rechts etwas. Nicht jeder Buchstabe. Sonst tickt die Stirn wie eine Uhr.
Das ist die Sorte Detail, die nur auffällt, wenn sie fehlt. Und die Sorte, bei der das Modell aus der Beschreibung „natürlicher" nichts machen kann. Man muss ihm sagen: drei Kanäle, Abfall auf dem Kantengraphen, Radius 55, 50, 45, Hals und Haare bleiben null. Dann baut es das in einer halben Stunde.
Sieben Versionen, fünf Jingles
Im Output-Ordner liegen sieben Versionen des Intros. Version 1 war eine Partikelwolke, die sich zu einem Kopf formt. Version 3 hatte den Titel. Version 4 das Zwinkern. Version 5 die erste Gesichtsanimation, mit einem Geist-Effekt auf der Stimme, den ich wieder rausgenommen habe. Version 6 das 3D-Rig. Version 7 den festen Hals, weil bei Version 6 der Hals noch mit dem Kiefer mitging, und das sieht man sofort. Dazu fünf Jingles, ruhig, ausgewogen, Zukunft, Wucht. Genommen habe ich am Ende einen der mittleren.
Fakt ist: Von sieben Versionen sind sechs Umwege. Aber jeder Umweg war ein Script, das man anschauen konnte, und ein Prüfbild, das gezeigt hat, was noch nicht stimmt. Das ist der Unterschied zu einem Tool, das ein fertiges Video liefert. Dort sieht man nur das Ergebnis und kann nichts lernen.
Was uns wirklich interessiert hat: die generischen Scripts
Jetzt der Teil, der über das Spielzeug hinausgeht. Was uns an dieser Studie genau interessiert hat, war nicht, ob das Modell einen Avatar hinbekommt. Sondern ob es die generischen Scripts sauber generiert, so wie wir sie wollten. Generisch heisst: Das Script kennt mein Gesicht nicht. Es kennt ein Netz, Gewichte, eine Achse. Man kann ihm morgen ein anderes Foto geben, ein anderes Netz, und es rechnet dasselbe. Ohne dass man ein Modell fragt.
Ein Ausschnitt, damit man sieht, was ich meine. Das ist die Stelle, an der jeder Punkt des Netzes sein Kiefergewicht bekommt. Nicht von Hand gemalt wie in Maya, sondern gerechnet: Ein paar Punkte werden festgesetzt, Lippen unten auf eins, alles oberhalb der Mundlinie auf null, und der Rest ergibt sich als harmonisches Feld auf dem Gitter. Eine dünn besetzte Laplace-Gleichung, ein Solve, fertig. Der Muskelzug ist eine zweite Rechnung: kürzester Weg auf den Kanten des Gitters, Dijkstra. Nicht geodätisch über die Fläche, und nicht als Kugel im Raum. Sonst zieht das Lächeln die Nase mit.
# Kiefergewicht: feste Ränder setzen, den Rest als harmonisches Feld lösen
pins = {}
for i in range(N):
    if V[i, 1] < mouth_mid[1] - 60: pins[i] = 0.      # oberhalb der Mundlinie: bewegt sich nie
    if i >= 468:                                       # Haar- und Bartschale
        if V[i, 1] > mouth_mid[1] + 35 and abs(V[i, 0] - V[152, 0]) < 145: pins[i] = 1.  # Bart folgt dem Kiefer
        elif abs(V[i, 0] - V[152, 0]) > 170: pins[i] = 0.                                 # Haare seitlich bleiben am Schädel
for i in UPPER + UPOUT: pins[i] = 0.
for i in LOWER[1:-1] + LOWOUT[1:-1] + [15, 16, 18, 200, 199, 175, 152]: pins[i] = 1.
for i in [78, 308, 61, 291]: pins[i] = .25                                                # Mundwinkel: ein Viertel

fixed = np.array(sorted(pins)); free = np.array([i for i in range(N) if i not in pins])
JAW = np.zeros(N); JAW[fixed] = [pins[i] for i in fixed]
JAW[free] = spsolve(LAPLACE[free][:, free] + diags(np.full(len(free), 1e-9)),
                   -LAPLACE[free][:, fixed] @ JAW[fixed])
JAW = np.clip(JAW, 0, 1)

# Muskelzug: Abfall entlang der Oberfläche, nicht als Kugel im Raum
def support(ids, radius):
    ds = dijkstra(GRAPH, directed=False, indices=ids, min_only=True)
    t = np.clip(1 - ds / radius, 0, 1)
    return t * t * (3 - 2 * t)                          # smoothstep, weich am Rand
Was daran sauber ist: Es gibt keine Zahl, die zu meinem Gesicht gehört, ausser den Indizes der Topologie, und die sind Standard. Es gibt keinen Aufruf an ein Modell. Es läuft in einer Sekunde auf einem Laptop. Und wenn ich morgen einen anderen Kopf riggen will, ändere ich die Anker, nicht das Script.
Das ist der Punkt, an dem viele heute falsch abbiegen. Sie lassen das Modell jedes Mal das Gesicht anschauen, jedes Mal die Gewichte schätzen, jedes Mal Tokens verbrennen. Für dasselbe Ergebnis, nur langsamer und teurer, und morgen ein bisschen anders. Wir machen es umgekehrt: Das Modell schreibt einmal das generische Script. Dann läuft das Script. Und das Modell fragen wir nur noch dort, wo eine Entscheidung ansteht, die kein Script treffen kann. Wo sitzt die Achse bei diesem Foto. Ist dieses Auge zu tief. Das sind wenige Fragen, und die sind es wert.
Das Muster ist bei dem Avatar dasselbe wie bei den fünfzig Micro-Modellen oder beim Prototyp für die Testdaten bei der Behörde. Nur sieht man es hier auf einer Bildschirmseite.
Warum man auch kleine Sachen bauen muss
Normalerweise sitzen wir an den hochkomplexen Sachen. Fünfzig Modelle am Leben halten, ein Prototyp für Testdaten bei einer Behörde, ein Agent, der sich nie selber abnimmt. Das ist die Arbeit, und sie ist gut. Aber sie hat einen Nachteil: Man sieht das Ergebnis erst nach Wochen. Und man verlernt, wie sich ein Modell anfühlt, wenn man ihm über die Schulter schaut.
Kleine Sachen zeigen, wie das Modell denkt. Bei einem grossen Projekt sieht man nur das Ergebnis eines Sprints. Bei einem Avatar sieht man jedes Script, jede Entscheidung, und wo es rät. Das lernt man nirgends besser.
Kleine Sachen halten das Handwerk wach. Ich hätte nicht gedacht, dass Maya-Wissen von anno noch einmal den Unterschied macht. Es hat. Wer nur noch Prompts schreibt, verliert das.
Kleine Sachen machen Freude. Das darf man sagen. Ein Kopf, der zum ersten Mal richtig „Ich bin Martin" sagt, mit einem Kiefer, der fällt und einem Hals, der bleibt, das ist ein guter Abend. Ohne diesen Teil würde ich den Rest nicht so lange machen.
Womit das gebaut ist
Das gehört klar hin, nicht in eine Fussnote. Die 468 Gesichtspunkte kommen vom Face Landmarker aus Google MediaPipe, und das Netz, das die Punkte verbindet, ist das kanonische Gesichtsmodell aus demselben Projekt, lokal angepasst. Beides steht unter der Apache-2.0-Lizenz, beides läuft bei uns lokal, kein Bild verlässt den Rechner. Ohne diese Vorarbeit wäre der erste Schritt, aus einem Foto ein Netz zu machen, allein Wochen gewesen. Was darauf aufbaut, der Kiefer als Knochen, die Muskeln, die Mundformen, die Brauen, ist unseres. Lizenz und Hinweise liegen im Repo und auf der Spielwiese bei.
Was bleibt
Der Avatar läuft in der Werkstatt, lokal im Browser, mit dem Rig aus dem Foto. Man kann ihm einen Satz geben, und er spricht ihn. Nicht perfekt. Ziemlich gut. Die Scripts liegen daneben, mit den Korrekturen von Hand, jede kommentiert, damit man sieht, wo Mensch war und wo Modell.
Ein Foto, 468 Punkte, ein Kiefer als Knochen, Muskeln als Zugrichtungen, zwölf Mundformen auf einer Uhr, drei Brauenkanäle. Das Modell hat die Scripts geschrieben. Ich habe gesagt, wo der Knochen wirklich sitzt und wann das Gitter sauber ist, weil ich das anno in Maya gelernt habe. Spielzeug, ja. Aber wer nur Grosses baut, vergisst, wie ein Modell arbeitet. Darum gehört auch das in die Werkstatt.
Geschrieben von mir. Die Gedanken, die Werte, die Learnings, die Fehler: alles meins. Grammatik und Rechtschreibung korrigiert ein eigenes Twin-Modell, das auf meinen Texten trainiert ist. Manchmal wird daraus ein Mix. Ich lese natürlich alles nochmal, aber niemand ist unfehlbar. Was drin bleibt, ist dann auch von mir.